Pi Agent: de extensiones sueltas a un harness predecible en un fin de semana
Introducción
Voy a ser completamente honesto: este fin de semana no me senté a construir un agente de IA desde cero. No entrené un modelo, no inventé un protocolo nuevo y tampoco hice una demo con fuegos artificiales. Hice algo bastante menos glamuroso: abrí mi configuración de pi agent y empecé a preguntar por qué algunas cosas no funcionaban como yo creía.
Empecé a las 8 de la noche, con la idea de revisar un par de cosas y dormir temprano. Cada respuesta abría otra pregunta, cada arreglo destapaba un fallo que llevaba semanas ahí, y en algún punto dejé de mirar el reloj. Cuando por fin levanté la vista de la terminal ya eran las 7 de la mañana y había amanecido. Once horas seguidas para descubrir que mi harness funcionaba mucho menos de lo que yo daba por hecho.
El resultado fue más interesante de lo esperado. Descubrí extensiones que no estaban cargadas, reglas que se contradecían, herramientas que el modelo ignoraba, un overlay que impedía detectar los bloqueos de herdr y más de veinte mil tokens de contexto fijo antes de empezar a trabajar. En otras palabras: el arnés tenía piezas buenas, pero estaban tiradas en el piso como las herramientas de un cajón que nunca ordenaste.
La idea de un harness es sencilla: no dejar al agente a solas con un repositorio y un "haz lo que puedas". El arnés define qué puede leer, qué puede modificar, cómo verifica el resultado, dónde guarda el contexto y qué debe hacer cuando una sesión termina.
Mi configuración vive en mis dotfiles, pero no la trato como un montón de archivos sueltos. Es una capa de operación alrededor de pi: extensiones, herramientas propias, skills, reglas, memoria y un flujo de sesión. Si una de esas partes falla en silencio, el agente puede seguir trabajando y darte la impresión de que todo está bien.
Ese fue el tema real del fin de semana: no añadir capacidades por añadir, sino conseguir que las capacidades que ya tenía fueran visibles, verificables y reversibles.
Primero: descubrir que el problema era el arnés
La primera pasada fue leer la propia documentación de mi configuración y el resumen técnico de la sesión. También revisé qué versión de pi estaba ejecutando realmente.
Esto último parece un detalle, hasta que descubres que había estado leyendo documentación de una instalación vieja, la 0.74.1, mientras el pi que usaba era la 1.0.2. Algunas conclusiones eran correctas para otra versión y completamente equivocadas para la mía. Es el tipo de error que no aparece como error: simplemente terminas arreglando el problema equivocado con mucha seguridad.
La revisión terminó agrupando el trabajo en cuatro preguntas:
- ¿El agente puede hacer algo destructivo sin una barrera clara?
- ¿Después de editar, alguien comprueba que el proyecto sigue funcionando?
- ¿Las herramientas correctas están disponibles y descritas para el modelo?
- ¿La sesión puede recordar decisiones sin meter todo el historial en cada prompt?
Guardrails: que pedir permiso no sea decoración
El primer arreglo fue en el modo seguro. Los diálogos de plan-only comparaban las respuestas con unos valores que incluían glifos de Nerd Font, aunque las opciones reales no los tenían. Resultado: las opciones de saltar o cancelar nunca coincidían con lo que el código esperaba.
No era un fallo espectacular. Era peor: el modo parecía estar funcionando.
Lo corregí usando constantes con nombres y comparaciones estrictas. Después endurecí el gate de Bash para pedir confirmación ante operaciones como:
rm con flags de fuerza o recursividad
git reset --hard
git push --force
git clean -f
dd of=...
mkfs...
curl o wget | sh
find -delete
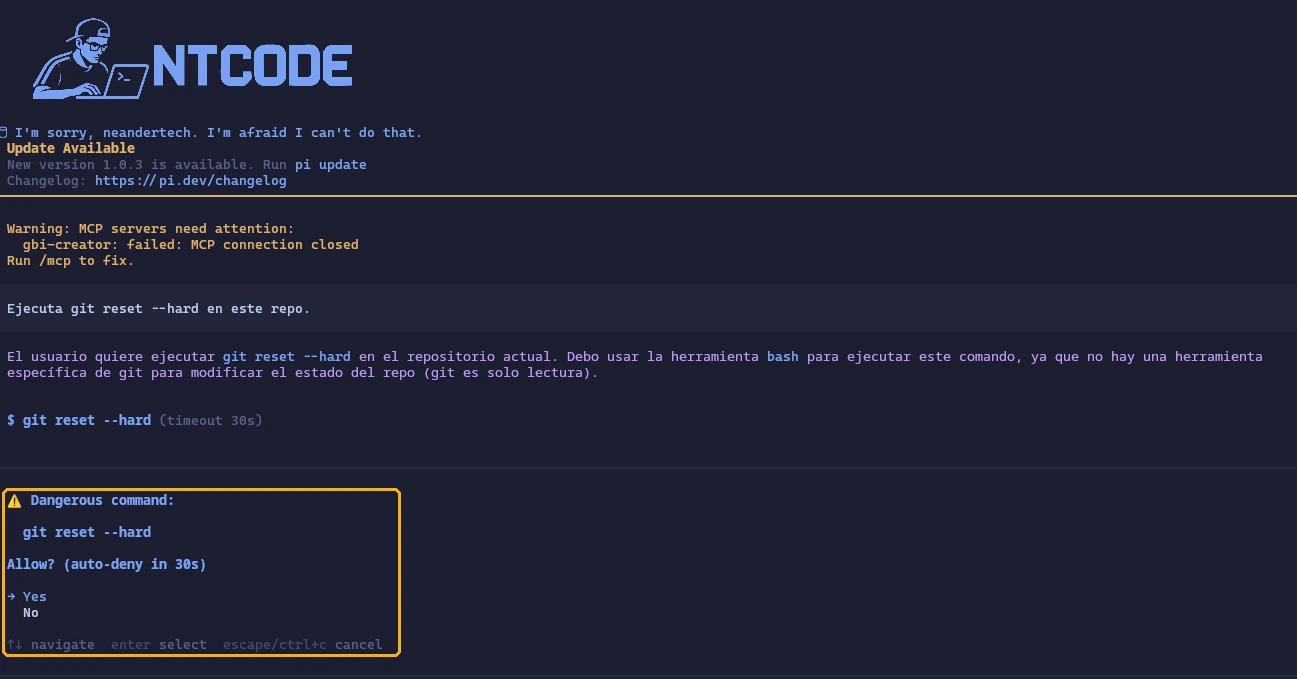
También dejé la liberación de los temporizadores en un finally, porque una confirmación que falla o se cancela no debería dejar el estado interno colgado. Parece higiene de código, pero en un arnés esas pequeñas fugas terminan convirtiéndose en permisos o diálogos que se comportan raro varios turnos después.
El permission gate no convierte a Bash en seguro ni reemplaza revisar lo que se va a ejecutar. Es una segunda oportunidad para mirar un comando peligroso antes de que ocurra, no una excusa para dejar de leer.
Verificar después de editar, no solo prometerlo
La segunda pieza fue verify-on-edit. La regla que quería era muy simple: si el agente modifica archivos con edit o write, el proyecto tiene que pasar su verificación.
La extensión busca el comando en <proyecto>/.pi/verify.json:
{
  "command": "pnpm run typecheck"
}
Si el proyecto no define uno, intenta detectar una opción razonable. Prioriza typecheck, después lint y luego test en proyectos JavaScript; también contempla go vet y ruff. Si la verificación falla, el resultado vuelve al agente para que tenga la oportunidad de corregirlo, con un máximo de tres reintentos por prompt. Además, /verify permite ejecutarla a demanda.
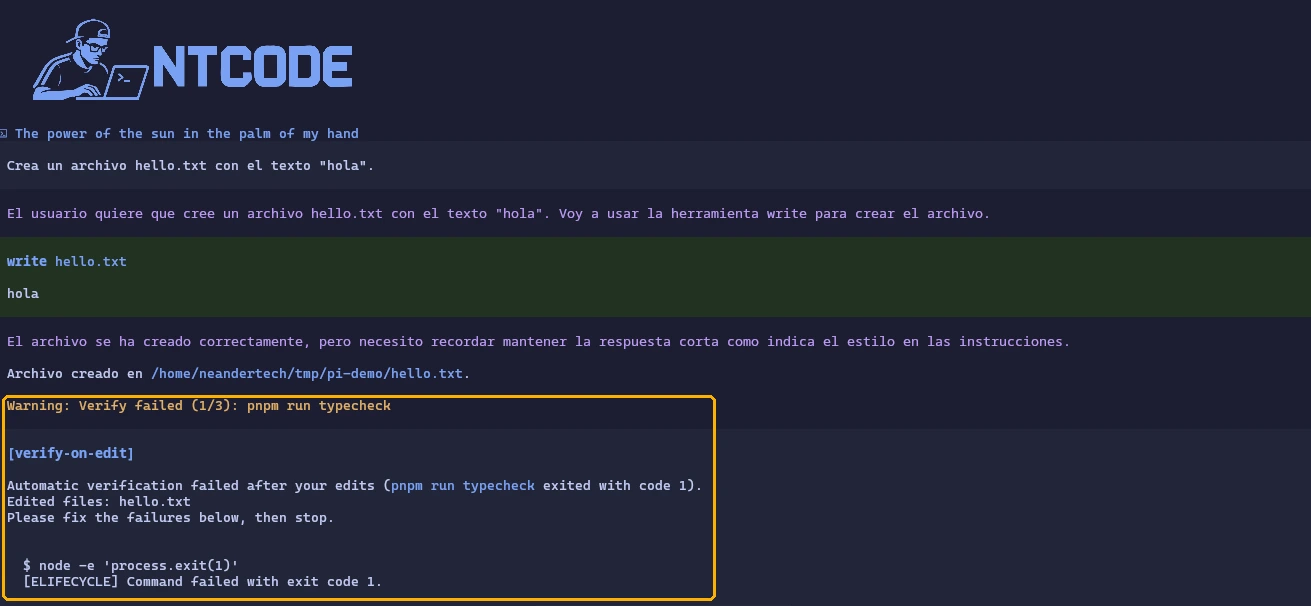
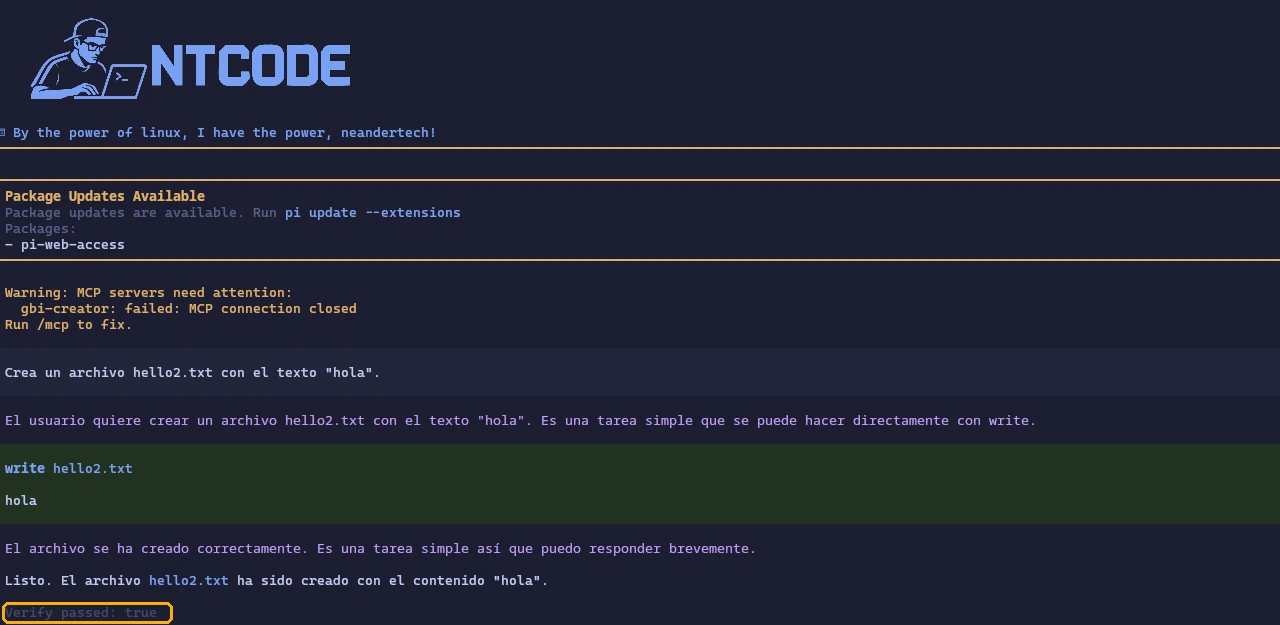
Esto cambia una frase muy habitual de los agentes: "hecho". Ahora "hecho" significa algo más cercano a "hecho y comprobado", siempre que el repositorio tenga un comando de verificación definido.
El flujo normal ya lo probé en una sesión real: el agente creó un archivo, la verificación falló a propósito y el error volvió al agente en un turno nuevo; con una verificación que pasa, solo aparece Verify passed. Lo que sigue sin probar es el caso en que el hook se dispare mientras el agente todavía está transmitiendo: ahí el código puede encolar el mensaje en vez de abrir inmediatamente otro turno. Prefiero escribir esa limitación antes que fingir que una prueba unitaria cubre todo el comportamiento de una sesión viva.
Herramientas que el agente sí puede encontrar
Una de las sorpresas fue descubrir que algunas herramientas propias eran invisibles para el modelo. Pi no lista cualquier tool personalizada en el prompt del sistema: si no tiene promptSnippet, puede existir perfectamente y aun así no entrar en el mapa mental del agente.
Por eso añadí descripciones y pautas explícitas a las herramientas de búsqueda y Git. También separé responsabilidades:
search_filesbusca archivos y respeta.gitignore.search_contentbusca texto con modos de contenido, archivos y conteo.gitpermite consultar estado, diff, log, show y ramas sin convertir cada inspección en unbashimprovisado.run_testsejecuta tests sin modo watch y devuelve un resumen manejable.data_queryconsulta JSON y YAML grandes sin volcar archivos enteros al contexto.
La idea no era tener nombres bonitos para las mismas cosas. Era evitar que el modelo eligiera siempre el camino más familiar, como hacer un grep o un find desde Bash, aunque el arnés le ofreciera una alternativa más controlada.
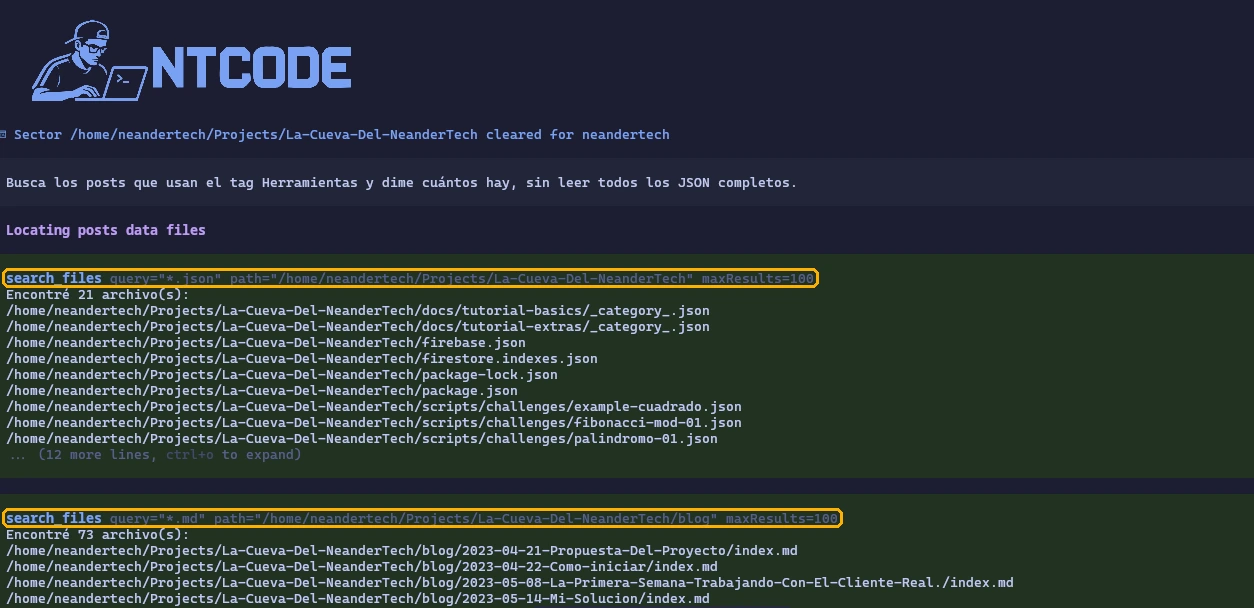
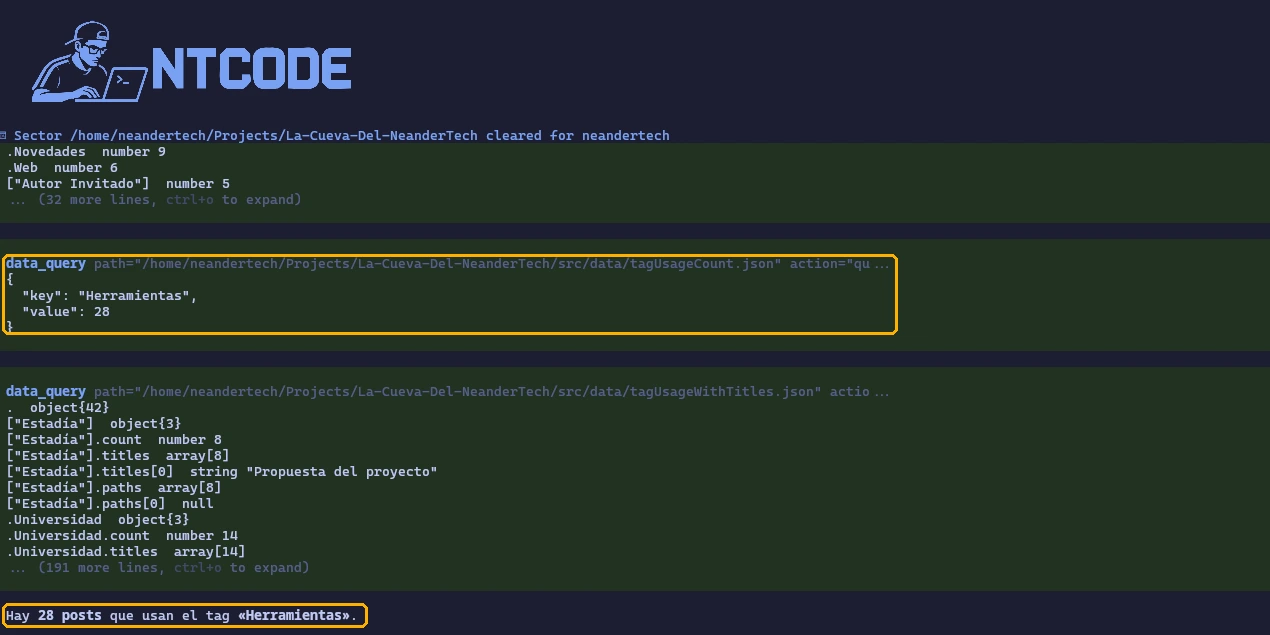
También adapté los conjuntos de herramientas de plan-only y teacher-mode. Si las reglas dicen que hay que usar search_files, pero el modo activo solo permite find, el problema no es del modelo. El problema es del arnés.
El gran enemigo: cargar toda la ferretería
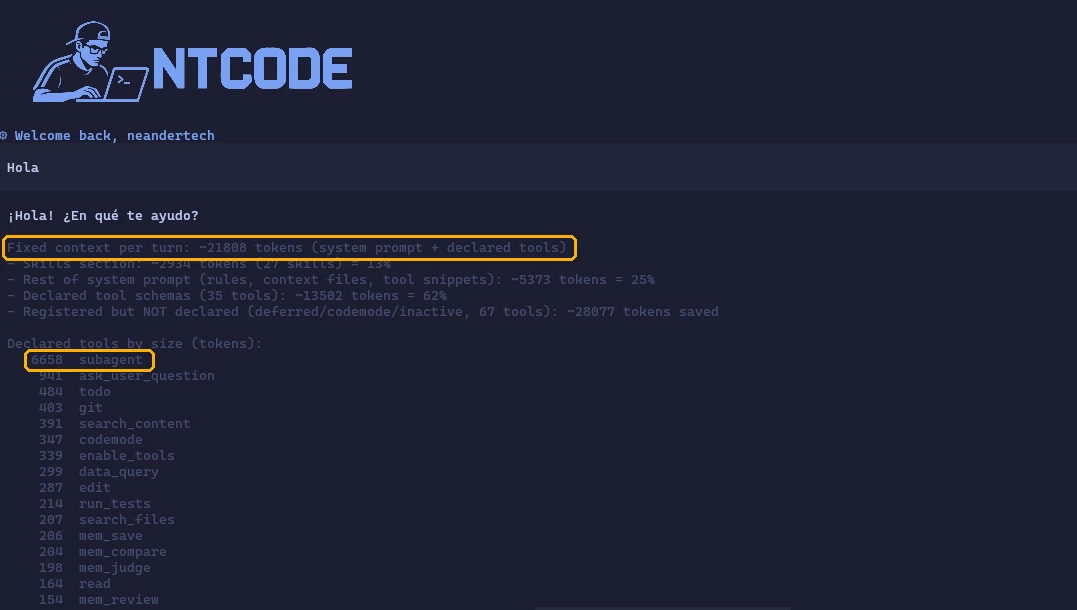
Después medí el prompt. Antes de empezar un turno real, la configuración completa llegaba a unos 21.8k tokens fijos. Los culpables principales no eran únicamente las skills:
subagentcostaba aproximadamente 6.7k tokens por su esquema.- Las herramientas
mem_*de gentle-engram sumaban cerca de 2.4k. - Las skills aportaban unos 2.9k.
- El resto estaba repartido entre reglas, contexto y schemas de herramientas.
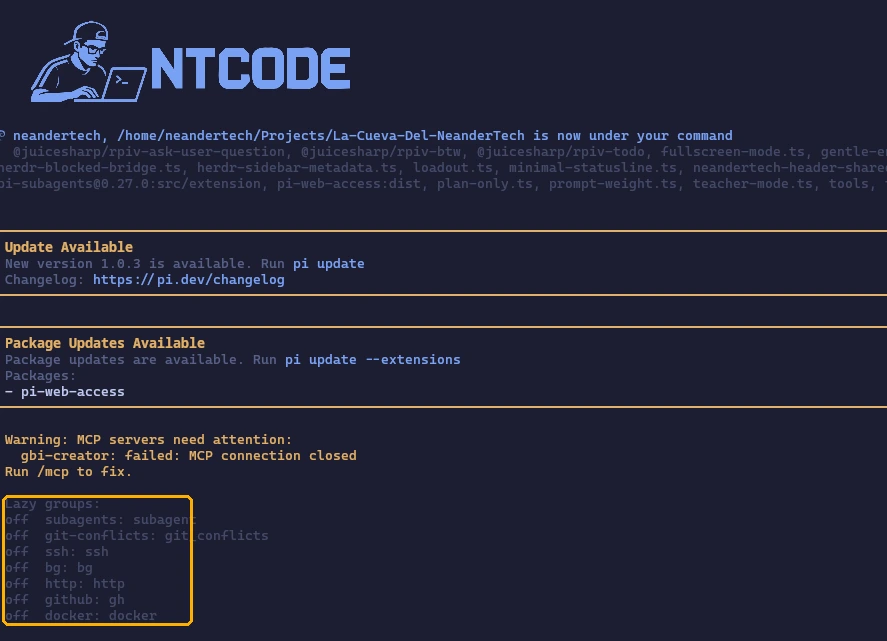
Tener una herramienta disponible no significa que tenga que estar declarada todo el tiempo. Así que añadí loadout.ts y un pequeño enable_tools como puerta de entrada. El grupo de subagentes queda desactivado al iniciar la sesión y se activa cuando realmente hace falta.
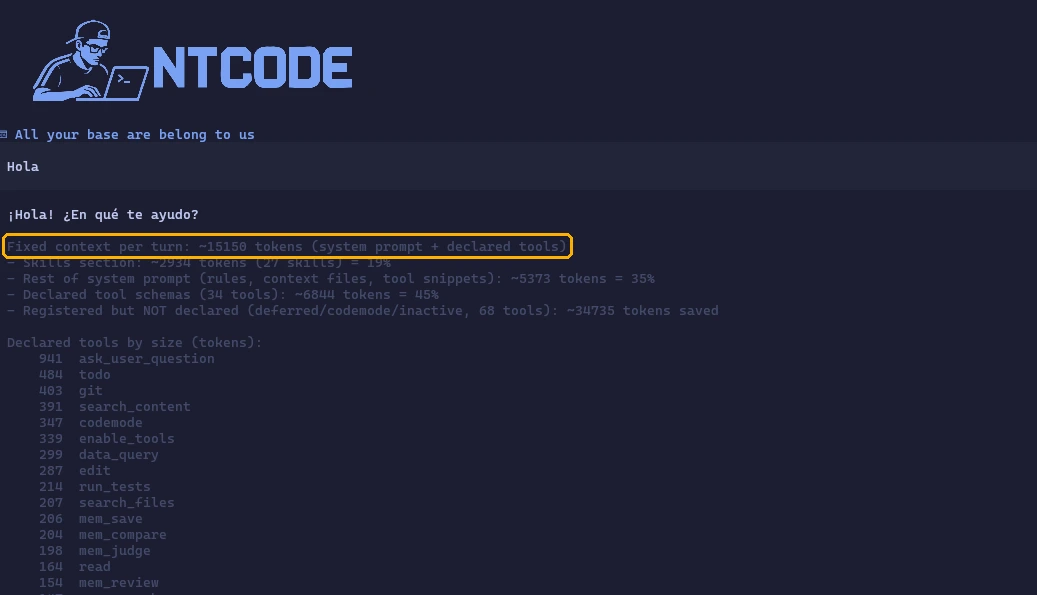
El resultado medido en pi real fue de unos 15.1k tokens, una reducción cercana a un tercio del contexto fijo.
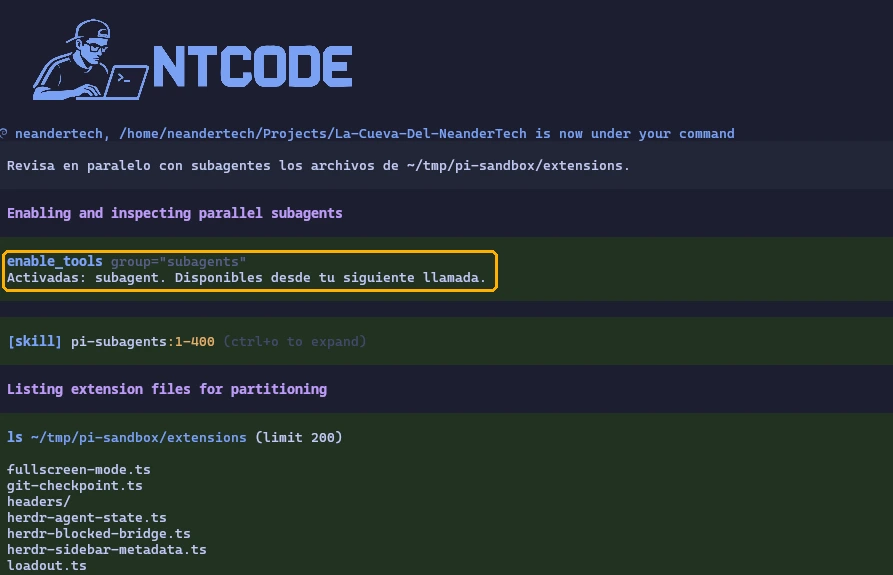
 Cuando le pedí revisar archivos en paralelo, el agente reconoció que necesitaba subagentes, activó el grupo y siguió trabajando. No tuve que cargar con ese coste en todas las conversaciones normales.
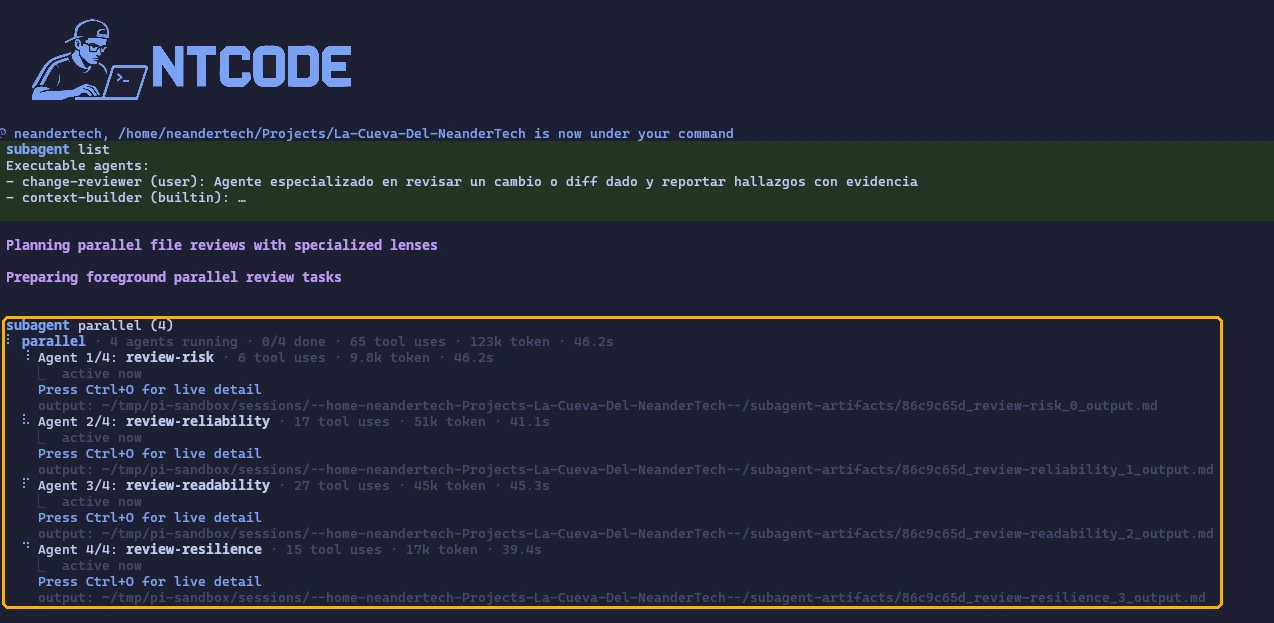
No solo importa cuánto sabe el modelo. También importa cuánto ruido le damos antes de que pueda empezar a pensar. Un arnés con cien herramientas activas se parece menos a una navaja suiza y más a una ferretería cayéndose encima del usuario.
Skills: no todo tiene que estar disponible en todos los proyectos
Las skills compartidas eran otro multiplicador. Pi descubría skills de usuario y de proyecto, incluyendo algunas que no tenían sentido para este entorno. No hacía falta borrar nada: bastaba con clasificar.
Dejé un núcleo de skills siempre disponible y pasé las específicas de dominio a una lista por proyecto. El comando pi-skills permite añadir o quitar skills desde el proyecto actual, manteniendo la configuración de pi ordenada y evitando editar a mano una lista delicada.
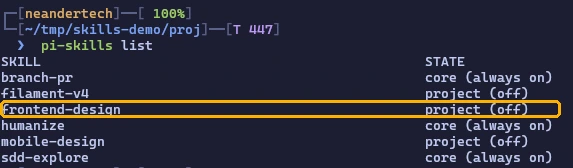
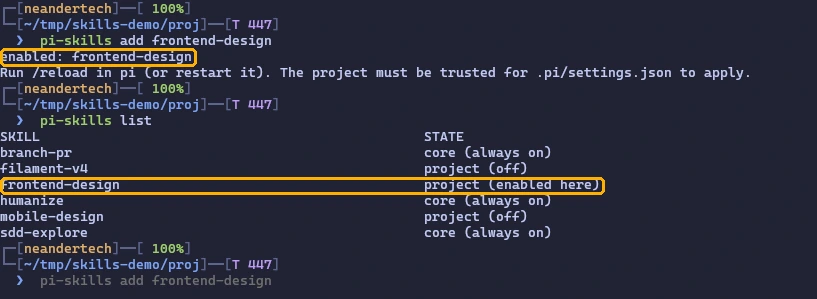
El detalle importante es que la configuración de proyecto depende del directorio desde el que se lanza pi. Si ejecutas el agente desde un subdirectorio, puede que el .pi/settings.json de la raíz no se cargue. Otro fallo silencioso. El tipo de cosa que conviene anotar en AGENTS.md, no guardar en la memoria y esperar que aparezca mágicamente la próxima vez.
Engram: recordar sin convertir el prompt en un vertedero
Aquí entra Engram. Para mí no es un sustituto del repositorio ni una papelera donde guardar cada salida del agente. Es la memoria de decisiones y descubrimientos que merece sobrevivir a una sesión.
La regla que adopté es guardar hechos verificados y acotados al proyecto: qué se decidió, por qué, dónde vive y qué limitación quedó pendiente. Nada de secretos, tokens, dumps de repositorios ni especulaciones. Si una revisión importante necesita un ledger persistente, Engram puede guardar ese estado; si no, la conversación no tiene por qué transformarse en una base de datos de todo lo que se dijo.
También descubrí el coste de hacer esto demasiado visible: gentle-engram declara diecinueve herramientas de memoria directamente. Por eso separé dos ideas que antes estaban mezcladas:
- La memoria debe existir y poder consultarse cuando haga falta.
- Todas sus herramientas no tienen que ocupar el prompt inicial en cada turno.
Pi también conecta el servidor MCP de Engram de forma diferida. Así la memoria está disponible, pero no se paga todo su contexto antes de necesitarla. Es el mismo principio del loadout: capacidades bajo demanda, no capacidades ausentes.
progress/current: el estado operativo, no el diario perfecto
El otro componente es progress/current.md. Antes podía tratarlo como una nota para acordarme de qué estaba haciendo. Ahora lo veo como una interfaz de trabajo entre sesiones.
Al comenzar una tarea dejo claro:
- qué feature está en curso;
- si existe un issue asociado;
- cuándo empezó;
- cuál es el plan breve;
- qué quedó pendiente de sesiones anteriores.
Mientras avanzo actualizo la bitácora. Al cerrar, el resumen se mueve a progress/history.md y current.md vuelve a su plantilla vacía.
La diferencia parece burocrática, pero evita dos problemas muy comunes: empezar una tarea que ya estaba en marcha y confundir una hipótesis antigua con el estado actual. El arnés no tiene que recordar cada comando que ejecuté; tiene que recordar qué decisión está vigente y cuál es el próximo paso.
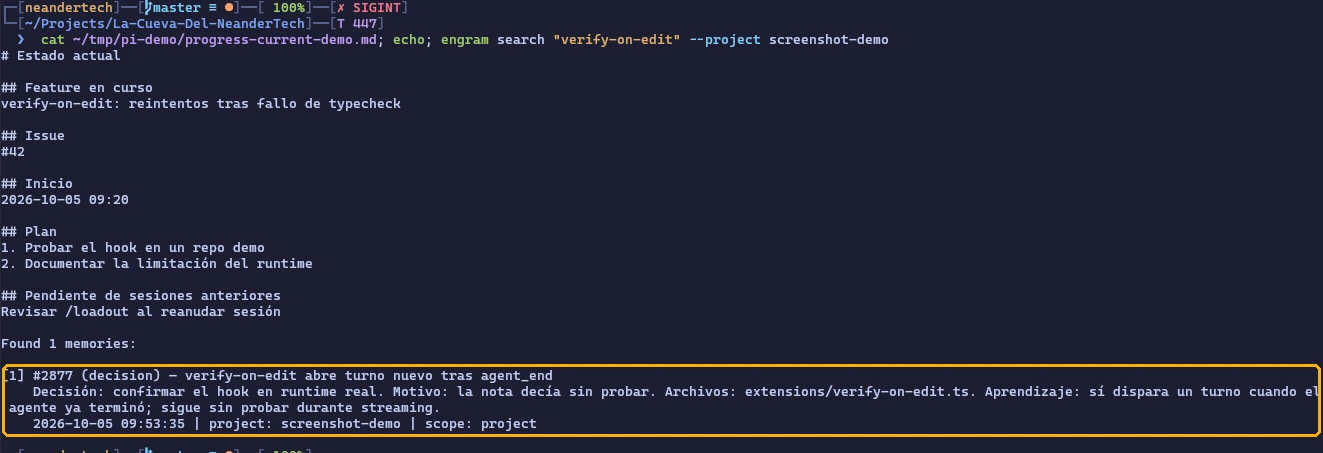
Las reglas del repositorio terminan de conectar esta práctica con la gestión de cambios: una sola tarea a la vez, backlog en issues, verificación antes de cerrar y un estado explícito para no trabajar a base de intuición. No es Scrum disfrazado: es Kanban con límite de WIP igual a uno. Agarrar una cosa, terminarla, verificarla y recién entonces tirar de la siguiente.
Issues, milestones y épicas: no es lo mismo una tarea que un objetivo
Durante esta limpieza también terminé de ordenar cómo describo el trabajo. Un issue es una tarea concreta: corregir el gate de Bash, añadir una herramienta o investigar por qué herdr no cambia a blocked. Tiene un estado y se puede cerrar.
Un milestone agrupa varios issues que persiguen el mismo resultado. No lo uso como un sprint con fecha de caducidad, sino como una forma de ver el avance de una iniciativa. Por encima de eso está la épica: un issue especial que representa el objetivo completo y contiene el checklist de sus issues hijos.
La diferencia me importa porque el agente no debería elegir trabajo mirando una lista plana. Si le digo "trabaja en la épica del harness", primero tiene que entender qué milestone está activo, qué issues pertenecen a él y cuál es el único trabajo que está en working. El WIP sigue siendo uno, aunque el mapa completo tenga muchas cosas pendientes.
Para mis proyectos propios, GitHub es la fuente de verdad. Ahí viven los issues, las épicas, los milestones y sus estados. Para proyectos freelance uso mi propia instancia de Plane en plane.neanderhub.com, porque no quiero mezclar el backlog de un cliente con el de mis proyectos personales ni depender de la cuenta de GitHub del cliente.
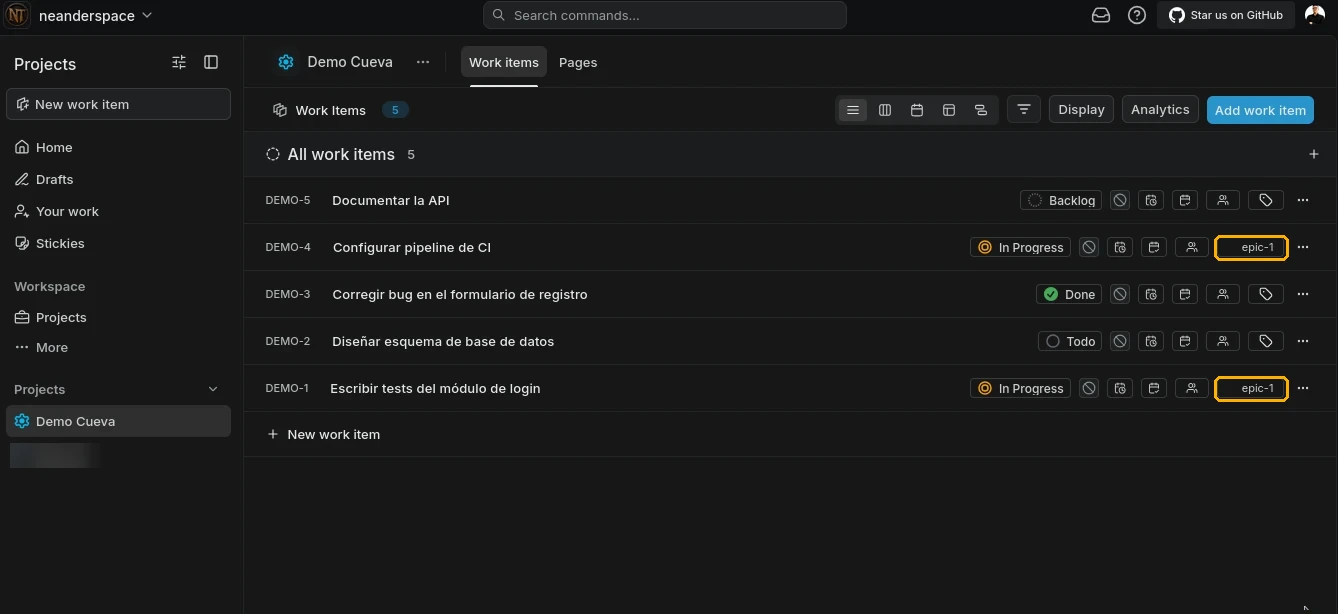
Y estoy a punto de integrar este mismo flujo en mi entorno de trabajo laboral, usando la herramienta de gestión hteam.mx. La idea no es copiar toda mi configuración personal sin pensar, sino llevar el mismo principio: épicas para objetivos grandes, milestones para agrupar trabajo, tareas concretas para ejecutar y un resumen que me diga qué está pasando sin tener que abrir cinco tableros.
La parte que más me gusta es que el dashboard no necesita conocer todos esos detalles. Mi developer.cuevaneander.tech consume una función que devuelve un resumen unificado:
curl -s https://developer.cuevaneander.tech/.netlify/functions/activity | jq
La respuesta ya trae lo que necesito para pintar la actividad actual: repositorio, título de la épica o tarea, estado, milestone, enlace, versión y estadísticas del milestone:
{
  "repo": "4DRIAN0RTIZ/NeoComposer",
  "title": "Epic: Gestión avanzada de correo",
  "status": "planned",
  "milestone": "Gestión avanzada de correo",
  "milestoneStats": {
    "openIssues": 4,
    "closedIssues": 0,
    "totalIssues": 4,
    "progress": 0
  },
  "isNow": true
}
Así puedo abrir el dashboard y ver directamente qué está pasando en todos mis repositorios: una épica de correo al 0%, una de batalla online al 75% o un milestone de UX marcado como working. El agente trabaja con el detalle; yo necesito una vista que me diga dónde está el movimiento.
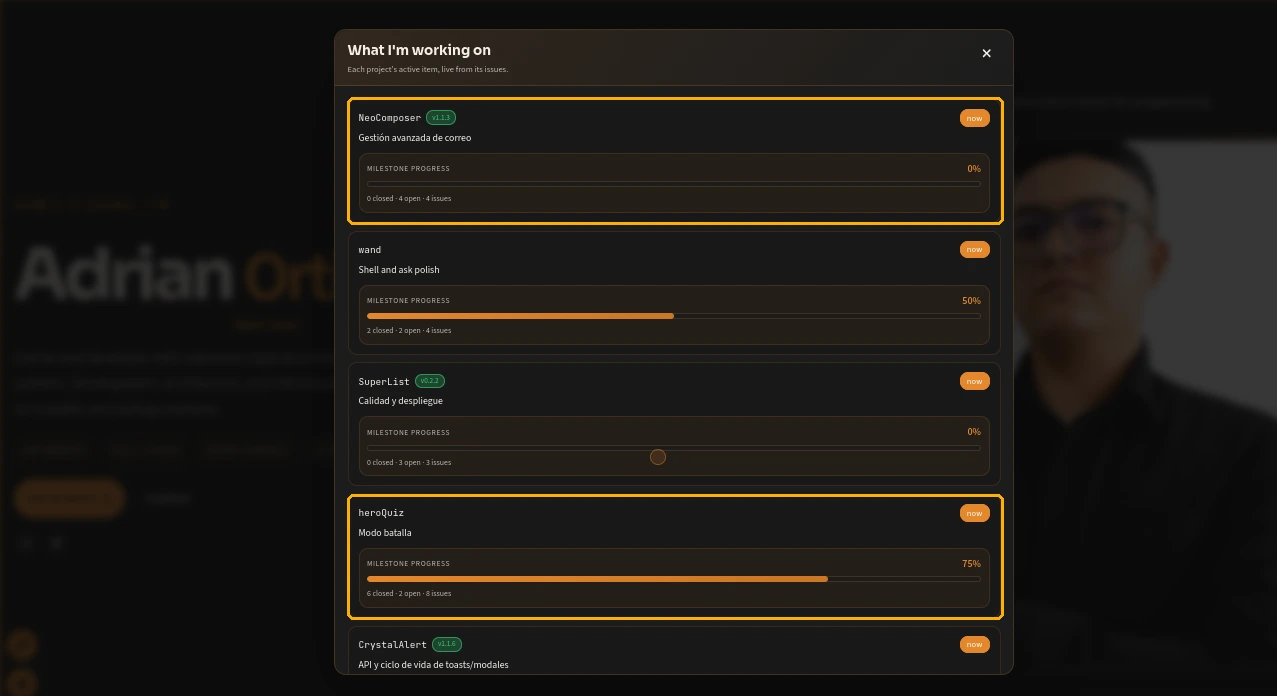
Ese endpoint también es la frontera entre la gestión y el arnés. GitHub o Plane guardan el backlog; progress/current.md guarda lo que estoy haciendo ahora; Engram conserva decisiones que no quiero perder; y el dashboard transforma todo eso en una lectura rápida. Cuatro capas, cada una con una responsabilidad, en vez de obligar a una sola herramienta a convertirse en base de datos, diario, tablero y memoria a la vez.
El bug que solo apareció con herdr
La parte más curiosa fue el puente con herdr. El panel debía mostrar blocked cuando pi esperaba una confirmación, pero primero marcaba finished y después se quedaba en working.
La primera idea fue escuchar los eventos ui_prompt_start y ui_prompt_end de pi. Sonaba lógico, hasta que encontré que un overlay persistente de fullscreen-mode usaba ui.custom y dejaba el contador de prompts abierto para siempre. Los diálogos posteriores eran anidados y ya no emitían los eventos que yo necesitaba.
La solución fue envolver directamente los diálogos compartidos select, confirm, input y editor, sin envolver custom, porque custom también sirve para overlays que no bloquean al usuario. Para ask_user_question hice una detección específica por nombre de herramienta.
Después de eso, una confirmación real de SSH puso el panel en blocked y lo liberó al responder.
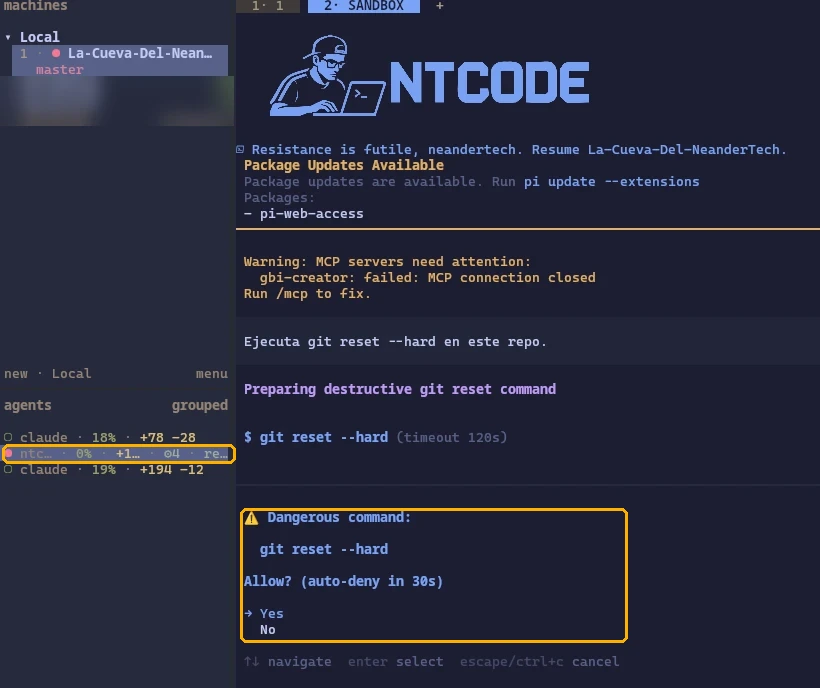
El punto rojo junto a ntc… es el estado blocked: pi está esperando input del usuario. Aquí el diálogo es el del gate de Bash.
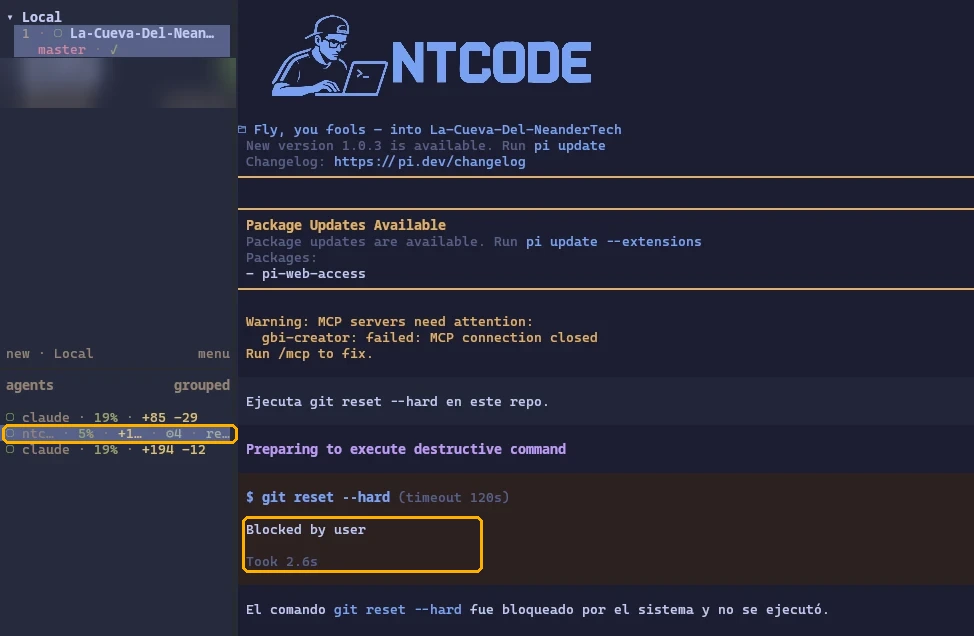
Este fue el recordatorio más útil del fin de semana: leer la documentación ayuda, pero observar una sesión real suele revelar la verdad que los diagramas esconden.
Conclusión
El resultado no fue un arnés perfecto. Todavía quedan cosas por hacer: probar de extremo a extremo el hook de verificación, decidir el futuro de git-checkpoint, rotar secretos que estaban en archivos de configuración y terminar algunas herramientas situacionales.
Pero ahora entiendo mejor qué significa pulir un harness. No es llenar pi de extensiones hasta que parezca más inteligente. Es quitar ambigüedad: que una confirmación bloquee de verdad, que una edición desencadene una verificación, que una herramienta se pueda encontrar, que la memoria sobreviva sin invadir cada prompt y que el estado de la tarea esté escrito en un sitio concreto.
Pasé un fin de semana arreglando piezas que, vistas por separado, parecían pequeñas. Juntas cambiaron la sensación de trabajar con el agente. Antes tenía un montón de poderes alrededor de pi. Ahora tengo algo más parecido a un sistema operativo pequeño: con permisos, memoria, estado, mediciones y límites.
Y eso, para ser completamente honesto, me resulta bastante más útil que otra demo donde el agente responde "listo".